La detección de anomalías con IA identifica automáticamente desviaciones relevantes en tus datos para evitar fallos, fraude o defectos antes de que generen coste. Aporta valor cuando ya cuentas con un histórico de datos mínimamente limpio y un KPI concreto que quieras mejorar (menos paradas, menos fraude, menos defectos). Si tienes ambas cosas, un proyecto piloto acotado suele bastar para validar el retorno antes de escalar.
En resumen:
- Es fundamental distinguir entre anomalías puntuales, contextuales y de grupo para seleccionar los algoritmos y evaluar resultados precisos en cada caso.
- Los métodos simples como PCA y control estadístico siguen siendo eficaces en procesos con relaciones conocidas y variables correlacionadas, antes de recurrir a deep learning.
- La evaluación del modelo debe centrarse en métricas operativas reales, como lead time y tasa de falsas alarmas, no solo en métricas globales como AUROC.
- Contratar un proveedor externo suele ser más eficiente que desarrollar infraestructura interna, sobre todo en casos con recursos limitados o necesidad de resultados rápidos.
Tabla de contenidos
- Qué es la detección de anomalías con IA y por qué importa a tu empresa
- Tipos de anomalías y en qué datos aparecen
- Algoritmos para detectar anomalías: qué técnica elegir según tu caso
- Casos de uso reales y las métricas que debes exigir
- Cómo implementar un proyecto de detección de anomalías: pipeline y validación
- Buenas prácticas y errores que hunden estos proyectos
- Cómo trabaja Codentix la detección de anomalías en proyectos reales
- ¿Externalizar la detección de anomalías o construirla con equipo interno?
- Empieza tu proyecto de detección de anomalías con Codentix
- Recursos y lecturas recomendadas
- Fuentes
- Preguntas frecuentes
Qué es la detección de anomalías con IA y por qué importa a tu empresa
Detectar anomalías consiste en identificar puntos, secuencias o grupos de datos que se alejan de lo que tu proceso considera “normal”. El concepto de normalidad no es fijo: se construye a partir del comportamiento histórico de tus máquinas, transacciones o usuarios, y cambia cuando el proceso cambia. Por eso una anomalía de hoy puede ser normalidad dentro de seis meses si tu línea de producción cambia de turno, proveedor o materia prima.
El interés de las empresas por este campo tiene una razón simple: el coste de no detectar a tiempo. Un fallo de máquina que se descubre tarde implica parada no planificada; una transacción fraudulenta no detectada implica pérdida directa; un defecto que llega al cliente implica devolución y reputación dañada. La detección de anomalías es relevante en sectores tan distintos como finanzas, ciberseguridad y manufactura, precisamente porque el patrón se repite: cuanto antes se identifica la desviación, menor es el coste de corregirla.
Los beneficios medibles suelen concentrarse en tres frentes:
- Reducción de tiempo de inactividad: anticipar el fallo permite programar el mantenimiento en vez de sufrir la parada.
- Ahorro por fraude o defectos evitados: cada transacción o pieza defectuosa detenida a tiempo es coste directo que no se materializa.
- Mejora del análisis de causa raíz: un sistema de IA bien integrado puede reducir la investigación de un incidente de semanas a horas, según recoge un análisis sobre control de calidad con IA en fabricación.
Ahora bien, ningún proyecto de este tipo está exento de límites. Los falsos positivos son el problema más citado por los equipos que operan estos sistemas: si el modelo genera demasiadas alertas irrelevantes, el equipo termina ignorándolas, y el sistema pierde su propósito. El etiquetado de datos también tiene coste, sobre todo en anomalías raras donde apenas existen ejemplos históricos. Y sin un volumen mínimo de datos representativos, cualquier algoritmo, por sofisticado que sea, producirá resultados poco fiables.
Tipos de anomalías y en qué datos aparecen
No todas las desviaciones se comportan igual, y confundir un tipo con otro es el primer error al diseñar un proyecto de análisis de datos con IA. Distinguir el tipo de anomalía que enfrentas condiciona qué algoritmo tiene sentido usar y cómo vas a validar sus resultados.
Anomalía puntual: un único registro se aleja del resto. Un pico de temperatura en un horno industrial o una transacción bancaria de importe inusual son ejemplos típicos. Es la más fácil de detectar porque no requiere contexto temporal.
Anomalía contextual: un valor es normal en un contexto pero anómalo en otro. Un consumo eléctrico alto es razonable en horario laboral, pero resulta sospechoso a las tres de la madrugada. Aquí el algoritmo necesita saber “cuándo” ocurre el dato, no solo “qué” valor tiene.
Anomalía de grupo o colectiva: ningún punto individual es anómalo, pero la secuencia o el conjunto sí lo es. Una sucesión de transacciones pequeñas y aparentemente normales puede esconder un patrón de fraude fragmentado que solo se ve al analizar el conjunto.
Estos tres tipos se manifiestan de forma distinta según el dominio de datos:
- En series temporales (sensores, consumo energético, procesos de fabricación), predominan las anomalías contextuales y de grupo, y el orden temporal es la clave del análisis.
- En visión por computador (inspección visual de piezas, control de calidad en línea), la anomalía suele ser puntual, localizada en una región concreta de la imagen.
- En logs de sistemas (ciberseguridad, monitorización de infraestructura), predominan las secuencias anómalas: un usuario que accede a recursos en un orden que nunca sigue.
- En datos multivariantes de proceso (temperatura, presión, caudal simultáneos), la anomalía casi nunca se ve en una sola variable sino en la relación entre varias.
Esta clasificación tiene una consecuencia práctica directa para el etiquetado y la evaluación: una anomalía contextual mal etiquetada como puntual generará un modelo que dispara alarmas en momentos perfectamente normales, inflando la tasa de falsas alarmas y erosionando la confianza del equipo que opera el sistema.
Algoritmos para detectar anomalías: qué técnica elegir según tu caso
La elección de algoritmo depende de tres cosas: cuántas variables interactúan, si tienes datos etiquetados y cuánta interpretabilidad necesitas frente a los reguladores o a tu propio equipo de operaciones.
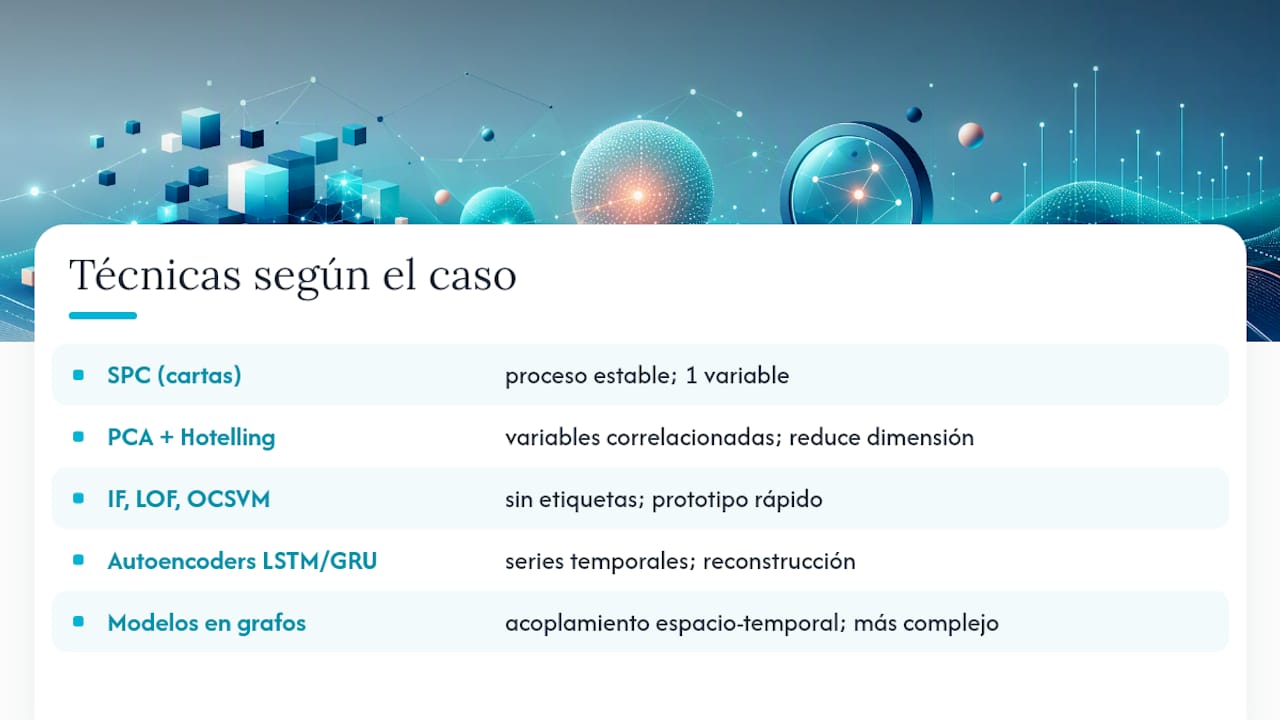
Los métodos de control estadístico de procesos (SPC) siguen siendo el punto de partida más razonable cuando el proceso es estable y las variables tienen relaciones conocidas. Las cartas de control clásicas funcionan bien con una sola variable, pero fallan cuando varias variables se mueven juntas. Ahí entra el análisis de componentes principales (PCA) combinado con estadísticos como Hotelling T² o SPE: reduce la dimensionalidad del proceso y detecta desviaciones que las reglas univariantes no ven porque atienden a la correlación entre variables, no a cada una por separado.
Consejo profesional: antes de saltar a deep learning, prueba PCA combinado con SPC. Es interpretable, reproducible y en procesos con variables correlacionadas suele acercarse mucho al rendimiento de modelos más complejos, con una fracción del coste de mantenimiento.
Un estudio aplicado a procesos químicos multivariantes mostró que un modelo PCA con tres componentes capturó una parte significativa de la variabilidad total del proceso y alcanzó sensibilidades de detección elevadas, cerca del 90 %, superando de forma clara a las reglas univariantes tradicionales.
Cuando no dispones de etiquetas y buscas algo más rápido de prototipar, Isolation Forest, Local Outlier Factor (LOF) y One‑Class SVM son las opciones estándar de aprendizaje no supervisado. Isolation Forest funciona bien con muchas variables y datos tabulares; LOF destaca cuando la densidad de los datos varía por regiones; One‑Class SVM aporta un límite de decisión más matemáticamente riguroso, aunque escala peor con volúmenes grandes. scikit-learn ofrece implementaciones maduras de los tres, lo que las convierte en la vía más rápida para validar una hipótesis antes de invertir en algo más pesado.
Para series temporales con dependencias complejas, los autoencoders y sus variantes recurrentes (LSTM, GRU) aprenden a reconstruir el comportamiento normal del proceso; cuando la reconstrucción falla, hay anomalía. Un trabajo sobre soldadura láser industrial confirmó que estos modelos superaron a métodos clásicos en AUROC y permitieron lead times operativos que anticipan el fallo antes de que ocurra. Los modelos basados en grafos son la opción más reciente para procesos con fuerte acoplamiento espacial y temporal entre sensores: las redes de similitud multiescala mejoran la rapidez de detección y reducen las falsas alarmas frente a enfoques tradicionales, aunque exigen más experiencia para ajustar e interpretar.
Casos de uso reales y las métricas que debes exigir
La inspección visual automática (AOI) es probablemente el caso de uso más extendido en manufactura: cámaras que analizan piezas en línea y disparan una alerta cuando detectan un defecto. En procesos de soldadura, los sistemas de detección de pre‑fallos analizan la señal del proceso en tiempo real para anticipar una rotura antes de que el cordón falle. En banca, la detección de fraude en transacciones combina reglas de negocio con modelos de anomalías para marcar operaciones sospechosas sin bloquear al cliente legítimo. En ciberseguridad, la detección de anomalías en logs identifica accesos o secuencias de comandos que se desvían del comportamiento habitual de un usuario o servicio.
En todos estos casos, evaluar el modelo con una sola métrica global es un error frecuente. Las métricas que realmente importan son:
- AUROC / AUC: mide la capacidad del modelo para separar casos normales de anómalos en distintos umbrales, útil para comparar algoritmos entre sí.
- Precisión y recall a un umbral operativo concreto: la métrica que de verdad usará el equipo, porque fija cuántas alertas reales se pierden y cuántas falsas se generan a ese umbral exacto.
- Tasa de falsas alarmas por día o por lote: determina si el equipo de operaciones va a confiar en el sistema o va a acabar ignorándolo.
- Lead time: cuánto tiempo antes del fallo real llega la alerta, la métrica que traduce directamente el modelo en ahorro de mantenimiento o de fraude evitado.
Un modelo con AUROC alto pero lead time bajo puede ser inútil en la práctica: detecta el fallo, pero demasiado tarde para actuar. La selección del algoritmo también debe hacerse por familia de producto o proceso, no de forma global, porque la variabilidad entre familias determina qué arquitectura rinde mejor en cada caso.
Cómo implementar un proyecto de detección de anomalías: pipeline y validación
Un piloto bien planteado sigue un orden que evita gastar presupuesto en la parte equivocada del proyecto.
- Prepara los datos antes de pensar en modelos. Limpia valores faltantes, define ventanas temporales coherentes con la dinámica del proceso y decide qué mínimo de etiquetado necesitas. Para inspección visual, cuenta con entre dos y varios cientos de imágenes de defectos por tipo como punto de partida razonable como punto de partida razonable; para SPC necesitarás entre tres y seis meses de parámetros de proceso, y para modelos predictivos más ambiciosos, más de doce meses de histórico.
- Diseña la arquitectura del pipeline de extremo a extremo. Ingestión de datos en tiempo real o por lotes, un almacén de características (feature store) que mantenga consistencia entre entrenamiento e inferencia, el propio entrenamiento del modelo, la inferencia en producción y, crucialmente, un sistema de monitorización que vigile si el modelo sigue funcionando bien con datos nuevos.
- Resuelve el desbalanceo extremo desde el diseño, no como parche final. En la mayoría de procesos industriales las anomalías representan menos del 1 % de los casos. Técnicas de sobremuestreo sintético, validación estratificada y métricas robustas frente a clases minoritarias son imprescindibles; entrenar y validar con la métrica equivocada aquí es la causa más común de proyectos que funcionan en laboratorio y fallan en producción.
- Define criterios de aceptación operacionales antes de desplegar. No basta con un AUROC aceptable en pruebas offline. Fija de antemano el lead time mínimo aceptable y la tasa máxima de falsas alarmas que tu equipo puede tolerar sin perder confianza en el sistema.
Consejo profesional: pide siempre la evaluación por familia de producto o línea de proceso, no una media global. Un modelo que funciona de maravilla en la familia A puede ser mediocre en la familia B, y una media enmascara ese problema hasta que ya está en producción.
Herramientas como Cómo identificar procesos que deben automatizarse ayudan a priorizar qué proceso conviene atacar primero cuando gestionas varias líneas candidatas a un piloto de detección de anomalías.
Buenas prácticas y errores que hunden estos proyectos
El error más repetido es empezar por el algoritmo en vez de empezar por el dato y el KPI. Un equipo entusiasmado con autoencoders puede pasar meses ajustando arquitecturas cuando el verdadero cuello de botella es que los sensores registran con ruido o frecuencia insuficiente.
- Define primero qué KPI de negocio quieres mover (paradas evitadas, fraude detenido, defectos rechazados) y solo después elige la técnica que mejor sirve a ese objetivo.
- Integra las alertas con el proceso operativo real: una alerta que llega a un correo que nadie revisa no genera ningún ahorro, por preciso que sea el modelo.
- Prueba la robustez del modelo frente a la deriva de datos (data drift): un proceso cambia con el tiempo, y un modelo que no se revisa periódicamente pierde precisión sin que nadie lo note hasta que ya es tarde.
- No confíes ciegamente en las métricas offline. Mejorar la captura de datos y aplicar métodos estadísticos robustos suele dar un retorno más rápido que saltar directamente a deep learning sin validar antes lo básico.
Consejo profesional: calcula el coste de operar el sistema de alertas, no solo el coste de construirlo. Un modelo que genera diez alertas diarias necesita alguien que las revise; si nadie tiene ese tiempo asignado, el proyecto fracasa aunque el modelo sea excelente.
Cómo trabaja Codentix la detección de anomalías en proyectos reales
Codentix aborda cada proyecto de detección de anomalías con una metodología en cuatro fases: análisis de viabilidad, prueba de concepto (PoC) acotada, integración con los sistemas existentes de la empresa y medición continua del retorno de inversión. Esta secuencia evita el error más habitual del sector, que es invertir en un modelo completo antes de confirmar que los datos disponibles soportan la hipótesis de negocio.
En la práctica, esto se traduce en pasos concretos:
- Un diagnóstico inicial que identifica si el proceso ya genera suficiente dato limpio para un piloto, o si primero hace falta trabajo de captura.
- Una PoC delimitada a un KPI y un plazo, no un proyecto abierto sin fecha de entrega.
- Integración de las alertas con las herramientas que el equipo ya usa, en línea con el enfoque aplicado en proyectos como la clasificación automática de emails entrantes con IA.
- Seguimiento de métricas operativas reales (lead time, tasa de falsas alarmas) más allá de indicadores de laboratorio.
Puedes conocer el enfoque completo en la página institucional de Codentix.
¿Externalizar la detección de anomalías o construirla con equipo interno?
La pregunta no es técnica, es de recursos. Si tu empresa no tiene un equipo de datos dedicado, montar la infraestructura interna para un solo proyecto de detección de anomalías rara vez compensa: el coste de contratar, mantener y actualizar ese conocimiento suele superar el de un proveedor especializado con experiencia previa en proyectos similares.
Un criterio útil: si la anomalía que buscas detectar afecta a un proceso crítico y necesitas resultados en semanas, prioriza un proveedor con una PoC acotada por contrato y pago por hitos, no un proyecto abierto. Esto limita el riesgo económico y te permite evaluar el ajuste real antes de comprometer presupuesto adicional. Al seleccionar proveedor, pide siempre evidencia de proyectos con métricas operativas reales, no solo cifras de laboratorio, y confirma que el trato técnico será directo, sin capas de gestión intermedia que diluyan la comunicación.
— Joan Jimenez Jané
Empieza tu proyecto de detección de anomalías con Codentix
Una alternativa a montar un equipo de datos interno es diseñar una solución de detección de anomalías adaptada al proceso, sin tecnología innecesaria, y con resultados medibles desde la primera fase del proyecto.
En vez de vender un paquete cerrado de software genérico, se analiza primero el proceso concreto (una línea de producción, un flujo de transacciones, un sistema de logs) y solo entonces se decide si la técnica adecuada es PCA, un autoencoder o un modelo basado en grafos. Este orden importa: evita pagar por deep learning cuando un control estadístico bien implementado resuelve el mismo problema a menor coste.
Si gestionas una línea de producción, un proceso de validación de transacciones o cualquier flujo donde una desviación temprana ahorraría dinero, revisa el servicio de automatizaciones con IA para empresas y solicita un análisis de viabilidad sobre tu caso concreto.
Recursos y lecturas recomendadas
Para profundizar en las técnicas descritas, conviene revisar el estudio sobre PCA aplicado a procesos químicos multivariantes, el trabajo de fin de máster sobre autoencoders en soldadura láser y el artículo sobre redes de similitud basadas en grafos. Para prototipar algoritmos clásicos, la documentación de scikit-learn sigue siendo la referencia técnica más práctica. El artículo de Babylovegrowth aporta contexto adicional sobre el impacto económico de estas tecnologías.
Fuentes
- Sistema de detección de anomalías en series temporales para procesos de soldadura láser (TFM)
- Control de calidad de la IA en la fabricación: más allá de la inspección visual
- scikit-learn: herramientas de machine learning en Python
Preguntas frecuentes
¿Qué es la detección de anomalías?
Es el proceso de identificar datos, eventos o comportamientos que se desvían de lo que un sistema considera normal, con el objetivo de detectar fallos, fraude o defectos antes de que generen coste. Se aplica en manufactura, finanzas y ciberseguridad, entre otros sectores.
¿Cuál es la mejor IA para hacer análisis de anomalías?
No existe una única mejor opción: depende del tipo de dato y de si tienes etiquetas disponibles. PCA y SPC funcionan bien en procesos multivariantes estables; Isolation Forest y One‑Class SVM son rápidos de prototipar con scikit-learn; los autoencoders y modelos basados en grafos rinden mejor en series temporales complejas con fuerte dependencia entre sensores.
¿Hay IA gratuita para análisis de datos?
Sí. Librerías como scikit-learn son de código abierto y permiten implementar algoritmos como Isolation Forest o One‑Class SVM sin coste de licencia. El coste real de un proyecto suele venir de la preparación de datos, la integración con tus sistemas y el mantenimiento del modelo, no del software base.
¿Cuáles son los tres tipos principales de aprendizaje automático?
Son el aprendizaje supervisado (entrena con datos etiquetados), el no supervisado (encuentra patrones sin etiquetas, como Isolation Forest o PCA) y el semisupervisado (combina pocos datos etiquetados con muchos sin etiquetar). En detección de anomalías, el no supervisado y el semisupervisado son los más habituales por la escasez de ejemplos anómalos etiquetados.
¿Cuánto cuesta implementar detección de anomalías con IA en mi empresa?
Puedes consultar el alcance y solicitar una valoración a medida en la página de automatizaciones con IA de Codentix.