Escalabilidad significa poder aumentar o reducir la capacidad de una aplicación interna sin perder rendimiento. Para la mayoría de pymes conviene empezar con escalado vertical, más sencillo de operar, y preparar la arquitectura para una transición horizontal cuando el crecimiento lo exija. Las tres palancas que marcan esa transición son el autoescalado, el uso inteligente de caché y unos KPIs bien definidos que avisen antes de que llegue el problema.
En resumen:
- La migración a escalado horizontal es recomendable solo cuando las métricas de CPU y memoria llevan varias semanas alcanzando su límite en horas punta, no en picos puntuales.
- La decisión entre escalado vertical y horizontal depende del nivel de experiencia del equipo, los requisitos de disponibilidad y el coste total de propiedad, no solo de la tecnología.
- Implementar patrones arquitectónicos como diseño sin estado, microservicios y balanceadores adecuados facilita la escalabilidad sin fricciones ni costos excesivos.
- La monitorización constante de KPIs como uso de CPU, latencia y profundad de colas permite anticipar cuándo es momento de ampliar recursos para evitar caídas de rendimiento.
- Planificar la escalabilidad en fases, con pruebas controladas y automatización, reduce riesgos y evita migraciones improvisadas que puedan ser costosas y tardías.
Tabla de contenidos
- Qué es la escalabilidad técnica: vertical, horizontal y autoescalado
- Cómo elegir entre escalado vertical y horizontal según tu negocio
- Patrones arquitectónicos que facilitan escalar apps internas
- Bases de datos: sharding, replicación y la elección entre SQL y NoSQL
- Qué KPIs indican que es momento de escalar
- Roadmap práctico para escalar tu aplicación interna en 3 a 6 meses
- Cómo aplica Codentix estas técnicas en proyectos reales
- Prioridades estratégicas y errores frecuentes al escalar
- Cómo te ayuda Codentix a escalar sin sobredimensionar tu infraestructura
- Fuentes
- Preguntas frecuentes
Qué es la escalabilidad técnica: vertical, horizontal y autoescalado
Escalar una aplicación interna significa darle más capacidad de cómputo, memoria o almacenamiento cuando el uso crece, sin que el rendimiento se degrade para los equipos que dependen de ella cada día. Existen dos caminos para lograrlo, y confundirlos suele ser el primer error de una empresa que empieza a notar lentitud en su CRM interno o en su herramienta de gestión de inventario.
El escalado vertical consiste en añadir más CPU, RAM o disco a la misma máquina. Es la opción más sencilla de implementar porque no exige rediseñar la aplicación, pero tiene un límite físico claro: llega un punto en que no existe una máquina más grande que comprar, o el coste de esa máquina deja de tener sentido frente al beneficio que aporta. El escalado horizontal, en cambio, reparte la carga entre varios nodos o servidores, y ofrece una capacidad prácticamente ilimitada a cambio de mayor complejidad de diseño.
El autoescalado añade o retira esos nodos de forma automática según la demanda real. Existen dos enfoques que conviene combinar:
- Autoescalado reactivo: responde a métricas en tiempo real (CPU, memoria, colas) cuando ya se ha detectado presión sobre el sistema.
- Autoescalado predictivo: anticipa picos conocidos, como el cierre contable de fin de mes o una campaña comercial con fecha fija. La combinación de ambos evita tanto el sobreaprovisionamiento constante como los cuellos de botella en momentos críticos.
Un autoescalado bien calibrado también reduce el gasto en infraestructura, porque libera recursos cuando la demanda baja en lugar de mantenerlos activos de forma permanente.
Cómo elegir entre escalado vertical y horizontal según tu negocio
La decisión no depende solo de la tecnología: depende de cuánto tiempo de ingeniería tiene tu equipo, qué nivel de servicio (SLA) te exige el negocio y cuánto presupuesto puedes destinar a infraestructura frente a desarrollo. Antes de decidir, conviene repasar cuatro criterios concretos:
- Naturaleza de los datos: si la aplicación maneja transacciones con fuertes dependencias relacionales, el escalado vertical suele ser más sencillo de mantener consistente.
- Exigencia de disponibilidad: un SLA del 99,9 % o superior casi siempre obliga a redundancia horizontal, porque una sola máquina no garantiza continuidad si falla.
- Coste total de propiedad: el vertical es rentable hasta gama media; superado ese punto, el precio de las máquinas de alta capacidad crece de forma desproporcionada frente al rendimiento que aportan.
- Capacidad del equipo técnico: migrar a horizontal exige experiencia en balanceo de carga, estado distribuido y despliegues automatizados; sin esa experiencia interna, el proyecto se alarga y encarece.
Un ejemplo habitual en pymes españolas: una herramienta interna de gestión de pedidos que funciona bien con una base de datos y un servidor de aplicación únicos mientras el equipo comercial es pequeño. Cuando la empresa abre nuevas delegaciones y el número de usuarios concurrentes se multiplica, esa misma arquitectura empieza a mostrar tiempos de respuesta lentos en las horas punta de la mañana. Ese es el momento de plantear la transición, no antes.
Consejo profesional: No migres a horizontal por moda. Hazlo cuando tus métricas de CPU o memoria lleven varias semanas tocando techo en horas punta, no ante un pico puntual que se resuelve solo.
La transición de vertical a horizontal conviene planificarla en pasos concretos:
- Verifica que la aplicación puede ejecutarse en varias instancias sin perder estado (sesiones, archivos temporales, colas locales).
- Introduce un balanceador de carga delante de las instancias antes de multiplicarlas, para no reescribir rutas de acceso más adelante.
- Prueba la redistribución de tráfico con carga real simulada antes de retirar la máquina vertical original.
- Automatiza el despliegue de nuevas instancias con infraestructura como código, para que escalar no dependa de un proceso manual.
Este orden reduce el riesgo de una migración a medias, que es peor que no migrar: deja a la empresa pagando la complejidad horizontal sin obtener aún su beneficio principal, que es la elasticidad.
Patrones arquitectónicos que facilitan escalar apps internas
Escalar sin fricción depende menos de comprar más servidores y más de cómo está construida la aplicación desde el principio. Los patrones de aplicaciones escalables y resilientes que documenta Google Cloud coinciden en varios principios que cualquier equipo de desarrollo interno puede adoptar de forma progresiva.
-
Diseño sin estado (stateless): cada instancia de la aplicación debe poder atender cualquier petición sin depender de datos guardados localmente. Las sesiones de usuario, los archivos temporales y las colas deben vivir en un almacén compartido (una base de datos, una caché distribuida) para que añadir o quitar instancias no rompa nada.
-
Microservicios con límites de dominio claros: dividir una aplicación monolítica en servicios independientes (facturación, inventario, notificaciones) permite escalar solo la parte que sufre presión, en lugar de multiplicar todo el sistema. Esto exige definir bien las fronteras de cada servicio; una división mal planteada genera más llamadas de red entre servicios de las que existían dentro del monolito original.
-
Balanceadores de capa 4 frente a capa 7: un balanceador L4 opera a nivel de transporte (TCP/UDP) y ofrece máximo rendimiento con mínima latencia añadida, ideal para tráfico homogéneo. Un balanceador L7 opera a nivel de aplicación (HTTP) y permite enrutar según la ruta, la cabecera o el contenido de la petición, lo que resulta útil cuando distintos microservicios comparten dominio.
-
Colas y trabajadores (workers) para desacoplar procesos pesados: tareas como generar informes, enviar notificaciones masivas o procesar archivos deben salir del ciclo de petición y respuesta principal. Una cola de mensajes permite que esos trabajos se ejecuten en segundo plano, con workers que escalan de forma independiente al resto de la aplicación. Este es el mismo principio detrás de la arquitectura orientada a eventos, que evita que un proceso lento bloquee al resto del sistema.
-
Despliegues sin tiempo de caída: estrategias como el despliegue azul-verde o el despliegue canario permiten introducir nuevas versiones sin interrumpir el servicio, algo especialmente importante en herramientas internas que se usan durante toda la jornada laboral.
Adoptar estos patrones desde el diseño inicial de una aplicación interna cuesta menos que reescribirla más adelante bajo presión, cuando ya está fallando en producción.
Bases de datos: sharding, replicación y la elección entre SQL y NoSQL
La capa de datos suele ser el cuello de botella real cuando una aplicación interna crece, incluso después de haber resuelto la escalabilidad de la capa de aplicación. Las señales de alerta suelen aparecer como sobrecarga de CPU o memoria en el servidor de base de datos, almacenamiento cerca del límite o saturación de red, según describe Couchbase en su análisis de escalabilidad de bases de datos.
Las bases de datos NoSQL suelen diseñarse desde el origen para escalar horizontalmente mediante particionamiento, lo que las hace atractivas para volúmenes de datos muy grandes o esquemas que cambian con frecuencia. Las bases SQL tradicionales ofrecen consistencia transaccional más fuerte, algo valioso en aplicaciones financieras o de facturación, aunque escalarlas horizontalmente exige más trabajo de diseño. Conviene tener en cuenta que algunos servicios SQL gestionados ofrecen ya capacidades de hiperescala, con escalado de almacenamiento hasta decenas de terabytes y restauraciones rápidas, lo que reduce la necesidad de migrar a NoSQL solo por volumen.
El sharding o particionamiento consiste en dividir los datos entre varios servidores según una clave (por ejemplo, el identificador de cliente o la región). Mejora el rendimiento a costa de mayor complejidad operativa: rebalancear particiones cuando crecen de forma desigual, o mantener consistencia entre ellas, exige herramientas y monitorización específicas.
Otras piezas que reducen la presión sobre la base de datos:
- Replicación: mantener copias de los datos en varios nodos mejora la disponibilidad de lectura y sirve como respaldo ante fallos; la replicación geodistribuida además acerca los datos a usuarios en distintas ubicaciones.
- Caché en memoria: guardar consultas frecuentes en una capa como Redis o Memcached evita golpear la base de datos en cada petición repetida.
- CDN para contenido estático: en aplicaciones internas con archivos, imágenes o informes descargables, una red de distribución de contenido reduce la latencia percibida sin tocar la base de datos.
- Pruebas de carga periódicas: detectar el punto de quiebre antes de que lo detecten los usuarios es la diferencia entre planificar una migración y improvisarla.
Qué KPIs indican que es momento de escalar
Escalar a tiempo depende de mirar los números correctos, no de esperar a que alguien se queje de lentitud. Cuatro métricas suelen bastar para tomar la decisión con criterio, tal y como recoge el análisis de IBM sobre escalado vertical y horizontal: uso de CPU, uso de memoria, latencia P95/P99 y tasa de errores. A estas conviene añadir la profundidad de las colas de trabajo, que anticipa saturación antes de que afecte al usuario final.
| KPI | Umbral de alerta habitual | Acción recomendada |
|---|---|---|
| Uso de CPU | Por encima del 70 % sostenido durante varios minutos | Añadir instancias o aumentar recursos |
| Uso de memoria | Por encima del 70 % sostenido | Revisar fugas de memoria o escalar |
| Latencia P95 | Supera el objetivo de negocio (SLO) definido | Investigar cuello de botella y escalar el componente afectado |
| Tasa de errores | Aumento sostenido frente a la línea base | Pausar despliegues y revisar capacidad |
| Profundidad de cola | Crecimiento continuo sin vaciarse | Añadir workers o revisar el consumidor |
Un ejemplo de regla concreta: subir capacidad cuando la CPU supera el 70 % durante tres minutos, y reducirla cuando cae por debajo del 30 % durante diez minutos. Ese margen entre umbrales de subida y bajada evita que el sistema oscile añadiendo y quitando recursos constantemente, un problema conocido como flapping.
Definir estos umbrales como SLOs (objetivos de nivel de servicio) conecta la conversación técnica con el negocio: un SLO de «latencia P95 por debajo de 400 milisegundos» es una frase que entienden tanto el equipo de desarrollo como la dirección. La estrategia más rentable suele combinar aprovisionamiento previo para picos previsibles (cierre de mes, campañas) con autoescalado reactivo para lo inesperado.
Roadmap práctico para escalar tu aplicación interna en 3 a 6 meses
Escalar una herramienta interna no exige rehacerla de golpe. Un plan por fases reduce el riesgo y permite corregir el rumbo antes de comprometer presupuesto grande.
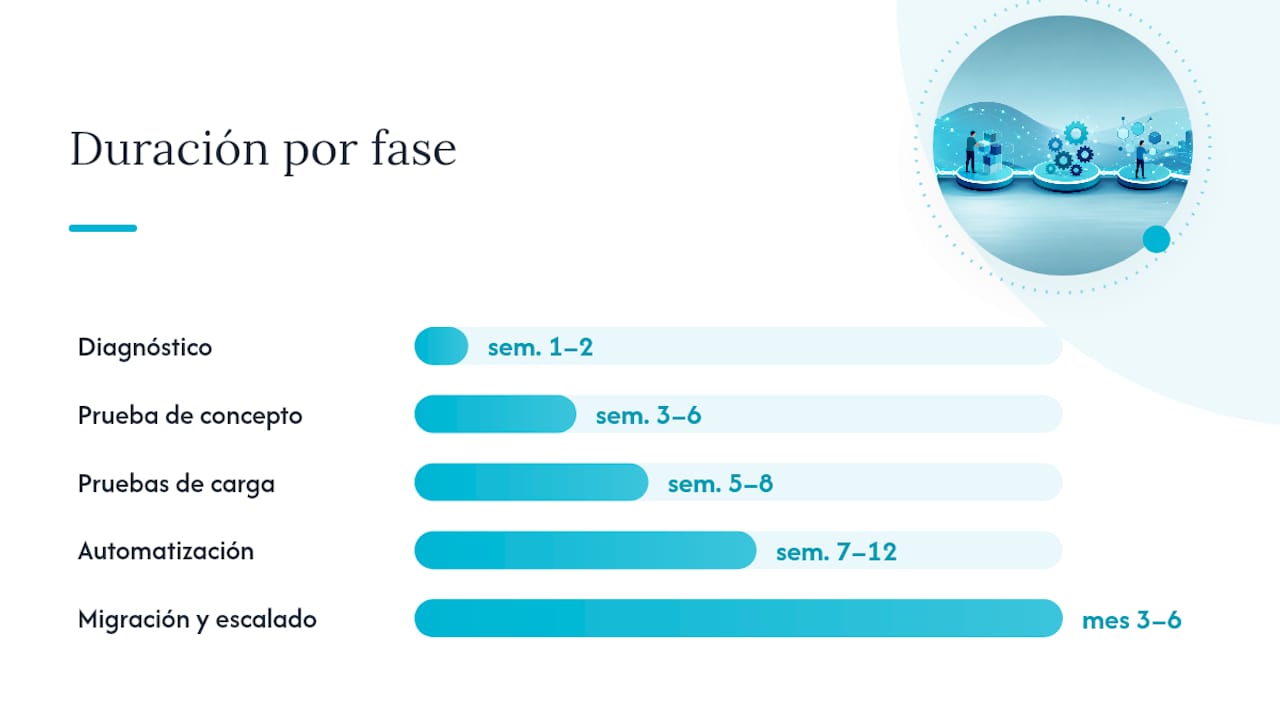
- Diagnóstico (semanas 1 a 2): mide los KPIs actuales, identifica el componente que primero llega a su límite y estima cuánto tiempo queda antes de que sea crítico. Este paso suele requerir un desarrollador senior y un responsable de operaciones.
- Prueba de concepto (semanas 3 a 6): valida en un entorno controlado el patrón elegido, sea desacoplar un proceso pesado con colas o introducir un balanceador de carga.
- Pruebas de carga (semanas 5 a 8): simula tráfico realista para confirmar que el umbral de escalado definido funciona antes de tocar producción.
- Automatización (semanas 7 a 12): implementa infraestructura como código y políticas de autoescalado, para que el crecimiento futuro no dependa de intervención manual.
- Migración y escalado definitivo (mes 3 a 6): despliega en producción con estrategia de despliegue sin caída, y mantiene monitorización activa durante las primeras semanas.
El checklist de buenas prácticas para herramientas internas escalables recomienda además revisar desde el inicio la paginación del lado servidor, los límites de tamaño de carga y el control de acceso por roles, porque corregir estos puntos más adelante suele costar más que incorporarlos en el diseño original. Una hoja de ruta de arquitectura escalable para pymes ayuda a decidir cuándo conviene refactorizar y cuándo directamente reescribir un módulo concreto.
Consejo profesional: Asigna a una sola persona la responsabilidad de vigilar los KPIs durante la transición. Repartir esa tarea entre todo el equipo suele acabar en que nadie la vigila de verdad.
Cómo aplica Codentix estas técnicas en proyectos reales
Codentix estructura sus proyectos de escalabilidad en cuatro fases: diagnóstico técnico y de negocio, diseño de la arquitectura objetivo, despliegue progresivo y soporte continuo tras la puesta en marcha. Este orden evita el error más habitual en pymes: invertir en infraestructura antes de saber exactamente qué componente necesita escalar y por qué.
El diagnóstico inicial identifica qué procesos manuales, qué integraciones rotas o qué cuellos de botella técnicos están limitando el crecimiento de la empresa. A partir de ahí, el diseño prioriza soluciones sin tecnología innecesaria: no siempre la respuesta es más servidores, a veces es automatizar un proceso repetitivo o rediseñar una consulta lenta a base de datos.
Sus proyectos de automatización y software a medida suelen generar un retorno de inversión medio superior al 300 % en seis meses, cifra que se atribuye a un enfoque en resultados medibles frente a soluciones genéricas.
Algunos recursos técnicos que profundizan en piezas concretas de este proceso:
- Diseño de bases de datos complejas con apoyo de agentes de inteligencia artificial, aplicable a procesos de datos que requieren estructuras avanzadas.
- Integración de sistemas y APIs para conectar herramientas internas que hoy operan de forma aislada.
- Optimización del flujo de trabajo interno como paso previo, muchas veces más barato que escalar infraestructura.
Prioridades estratégicas y errores frecuentes al escalar
La tentación más común en pymes es tratar la escalabilidad como un problema puramente técnico, cuando en realidad es una decisión de prioridades. Escalar demasiado pronto, antes de validar que el producto o el proceso interno funciona, desperdicia presupuesto en una arquitectura que quizá nunca haga falta usar a esa escala. Escalar demasiado tarde, en cambio, convierte una migración planificada en una emergencia de fin de semana.
El error que más retrasa proyectos no es técnico: es la falta de alineación entre dirección y equipo técnico sobre qué SLA es realmente necesario. La deuda técnica, por su parte, no debe pagarse toda de golpe: conviene priorizar la que bloquea directamente el siguiente hito de crecimiento y posponer el resto sin remordimiento.
Mi recomendación para equipos directivos es simple: pide a tu responsable técnico que traduzca cada decisión de escalado a una cifra de negocio, ya sea coste evitado, tiempo ahorrado o riesgo reducido. Esa disciplina evita tanto la sobreingeniería como la parálisis por miedo a equivocarse.
— Joan Jimenez Jané
Cómo te ayuda Codentix a escalar sin sobredimensionar tu infraestructura
Una empresa puede optar por contratar un proyecto con diagnóstico, diseño y despliegue ya resueltos, con trato directo del equipo técnico y sin intermediarios comerciales, en lugar de montar un equipo interno de infraestructura desde cero.
Un proyecto típico de escalabilidad con Codentix arranca con un desarrollo de software a medida o una revisión de la arquitectura existente, sigue con la automatización de procesos que hoy consumen tiempo manual, y puede incluir integraciones con tus sistemas actuales o un dashboard a medida para monitorizar los KPIs que decidas priorizar. Si tu aplicación interna empieza a mostrar los síntomas descritos en este artículo (lentitud en horas punta, errores intermitentes, colas que no se vacían), puedes Codentix para saber qué combinación de escalado vertical, horizontal o automatización tiene sentido para tu caso concreto.
Fuentes
Para profundizar en los conceptos de esta guía, Akamai y Microsoft Azure explican con detalle la diferencia entre escalado vertical y horizontal. Google Cloud documenta patrones de arquitectura resiliente aplicables a cualquier stack. Couchbase cubre en profundidad los retos de escalar bases de datos, y BabyLoveGrowth ofrece perspectivas adicionales sobre automatización y tráfico a escala.
- What is horizontal scaling vs vertical scaling (Akamai)
- Patrones de apps escalables y resilientes (Google Cloud)
- Database Scalability: Horizontal & Vertical Scaling Explained (Couchbase)
Preguntas frecuentes
¿Qué diferencia hay entre escalabilidad vertical y horizontal?
El escalado vertical añade más CPU, RAM o disco a un mismo servidor, mientras que el horizontal reparte la carga entre varios nodos. El vertical es más rápido de implementar; el horizontal ofrece más margen de crecimiento a largo plazo.
¿Qué aplicaciones o herramientas ayudan a escalar una app interna?
No existe una herramienta única: la escalabilidad combina infraestructura en la nube con autoescalado, balanceadores de carga y bases de datos preparadas para particionamiento. Servicios de automatización e integración pueden ayudar a reducir la carga sobre los sistemas antes incluso de tocar la infraestructura.
¿Cuáles son los tipos de escalabilidad que debo considerar?
Los dos tipos principales son vertical y horizontal, y a menudo se combinan con autoescalado reactivo o predictivo según el patrón de demanda. La elección depende de tu SLA, tu presupuesto y la experiencia técnica disponible en tu equipo.
¿Qué ejemplos de negocios o procesos son especialmente escalables?
Los procesos con reglas claras y repetibles, como facturación, gestión de inventario, atención al cliente o generación de informes, suelen escalar bien porque se prestan a automatización y a arquitecturas sin estado. La automatización de procesos suele ser el primer paso antes de invertir en más infraestructura.
¿Cuándo debe una pyme empezar a planificar la migración a escalado horizontal?
Cuando los KPIs de CPU, memoria o latencia P95 llevan varias semanas tocando techo en horas punta de forma sostenida, no ante un pico aislado. Antes de migrar conviene verificar que la aplicación puede funcionar sin estado local, tal como recomienda Google Cloud en sus patrones de aplicaciones resilientes.